指南
什么是本机转写?
本机转写(也叫端侧转写、离线转写)指语音识别模型直接运行在手机等设备上,音频不需要上传到服务器就能变成文字。对会议、访谈这类敏感内容来说,这意味着更小的数据暴露面。
- 核心转写在本机完成,录音不需要上传。
- 首次使用需下载并校验语音识别模型。
- 模型就绪后,核心转写不依赖录音上传。
本机转写是怎么工作的
本机转写把语音识别的计算放在设备本地完成,通常包含三个环节:
- 模型下载与校验。首次使用前,应用把语音识别模型下载到设备上并校验完整性。
- 设备内计算。录音在手机上被切分、识别,并整理成带时间信息的文字稿。
- 结果保存在本地。文字稿与录音一起保存在设备存储中,由你决定何时分享或删除。
本机转写与云端转写的差异
两种方式都能把语音变成文字,区别主要在数据去向、网络依赖和算力来源。
| 对比项 | 本机转写 | 云端转写 |
|---|---|---|
| 音频去向 | 保留在设备上 | 上传到服务商的服务器 |
| 网络依赖 | 核心转写不依赖上传录音;下载模型需要网络 | 每次转写都需要稳定网络 |
| 处理速度 | 取决于设备性能与录音时长 | 取决于网络状况与服务器排队 |
| 隐私边界 | 数据留在设备,由你掌控 | 需要信任服务商的数据处理流程 |
| 能力上限 | 受设备算力与模型体积限制 | 可调用更大模型与跨设备能力 |
为什么会议内容更适合本地处理
会议里常有客户信息、商业计划、人事讨论和未公开的决策。把这些录音上传到第三方服务器,意味着多一层传输、存储和访问控制的风险。本机转写遵循数据最小化的原则:能留在设备上的内容,就不发出去。
这也是语可寻把转写放在设备上完成的原因:录音、文字稿和说话人信息默认都留在本机,服务器不参与核心转写链路。
本机转写有哪些限制
- 首次准备。需要下载并校验模型,同时预留相应的存储空间。
- 设备负载。转写速度受芯片性能、电量和后台任务影响,老设备会更慢。
- 模型边界。远距离、强噪声、多人抢话会降低准确率。
- 功能范围。跨设备同步、多人云端协作等能力通常属于云端方案。
语可寻如何完成本机转写
- 在应用内录制会议、访谈或课程。
- 首次转写前下载并校验本地语音识别模型。
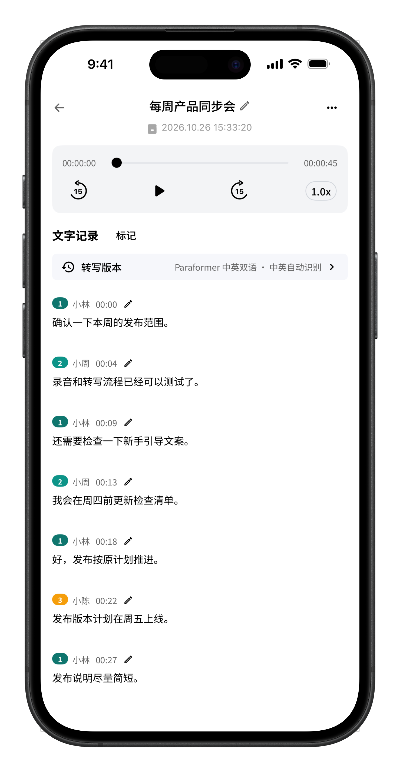
- 录音在设备上完成识别与说话人识别,文字稿按时间轴排列。
- 用全文搜索定位关键词,点击结果即可回到对应的录音位置。
核心转写链路不把录音或文字稿上传到语可寻服务器。全文搜索是 VIP 权益;文字稿可以编辑,并通过系统分享面板导出 Word 文档或分享原始音频。
适合哪些场景
本机转写适合对隐私敏感、又需要可检索记录的场景:会议记录、客户访谈、课程与讲座、个人备忘。录制前请确认在场每个人都知情并同意录音。
常见问题
本机转写和云端转写哪个更准确?
准确率取决于模型、录音质量和场景,不能一概而论。安静环境、清晰拾音时两者都可以有很好的表现;强噪声、远距离或多人抢话时差异会更明显。重要会议前建议先试录一分钟确认效果。
使用本机转写需要联网吗?
首次下载并校验语音识别模型需要网络。模型就绪后,核心转写不依赖上传录音;订阅权益校验等操作仍可能需要网络。
我的录音会上传到服务器吗?
语可寻的核心转写链路不会把录音或转写文本上传到服务器。录音与文字稿默认保存在设备上,只有你主动导出或分享时才会离开设备。
本机转写会很耗电吗?
转写属于计算密集型任务,录音越长、设备越旧,耗时和耗电越明显。处理长录音时建议保持电量充足,必要时连接电源。
开始使用
用本机转写记录下一场会议
免费下载,包含 60 分钟转写额度;无需注册账号即可开始。