ガイド
iPhone での話者分離
話者分離(ダイアライゼーション)は、文字起こしを「誰がいつ話したか」で整理します。壁のようなテキストが、追えて、検索できて、メモにできる会話になります。これは声による個人の特定ではありません。アプリは匿名の声にラベルを付け、その人が誰かは自分で決めます。
- 話者分離は誰がいつ話したかにラベルを付けます。人の名前を知っているわけではありません。
- 明確な発言の切り替え、静かな部屋、中央に置いたマイクが最良のラベルをもたらします。
- 同時発話、似た声、ごく短い返答は難しいケースです。
- Scribo では文字起こしの後に話者グループの名前変更、調整、統合ができます。
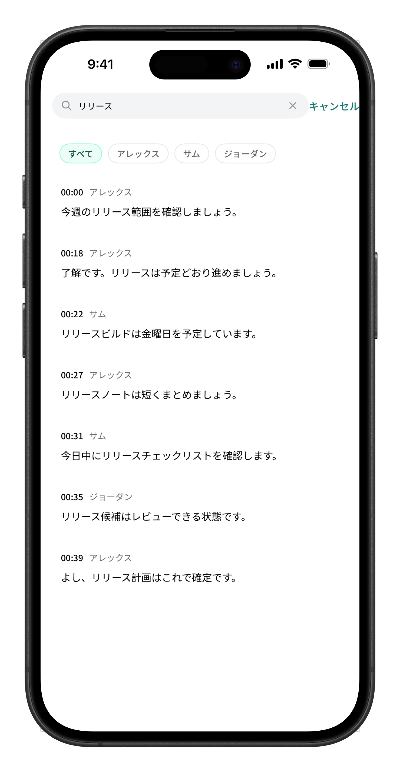
話者分離が実際に行うこと
話者分離は2つの段階で動作します。
- セグメンテーション。録音を、無音で区切られた短い発話区間に分割します。
- グループ化。同じ声に聞こえる区間を、「話者1」「話者2」などの1つのラベルにまとめます。
結果は、会議のやり取りを追える文字起こしになります。ただし、人を特定するわけではありません。声をアカウント、連絡先、名前に結び付けることはなく、Scribo ではラベルは匿名で始まり、名前を変更できます。
会議やインタビューで重要な理由
- 読みやすさ。話者の切り替えがない文字起こしは拾い読みしにくくなります。ラベルがあると構造が見えます。
- メモと議事録。誰が論点を出し、誰が同意し、誰が次のステップを担うかが分かります。
- 検索。全文検索は VIP の特典で、キーワードと話者を指定して該当する音声に戻れます。
- 確認。後から決定に疑問が出たとき、話者ラベルとタイムスタンプがあれば会話を検証しやすくなります。
Scribo での話者分離の扱い
- 音声認識と1回の会議内の話者分離は端末上で実行されます。
- 文字起こしには、タイムラインに沿ってタイムスタンプ付きの話者ラベルが表示されます。
- 文字起こしの後に、話者の名前変更、グループの調整、同じ人のグループの統合ができます。
- セグメントをタップすると、録音のその位置に戻れます。
話者分離が難しい理由
ダイアライゼーションはベストエフォートの処理であり、保証されたものではありません。よくある失敗は神秘的なものではなく、物理的なものです。
- 同時発話。2人が同時に話すと、音声には2つの声が混ざります。
- 距離と騒音。大きなテーブルの向こう側のスマートフォン、エアコン、カフェの背景音は、声の手がかりをぼやけさせます。
- 似た声。声の高さやリズムが似ている人は混同されやすくなります。
- 短い相づち。短い「はい」「了解」は、安定してグループ化するのに十分な音声を含まないことがあります。
- 速いターン交代。文の途中で割り込む話者がいると、1つの連続した発話区間になります。
- 言語の切り替え。1つの会議で言語が混ざると、モデルが扱うべき変化が増えます。
話者ラベルをきれいにする方法
- スマートフォンをテーブルの中央付近に置く。端に置くより、中央に1台置くほうが通常は良好です。
- 背景の騒音を減らす。窓を閉め、エアコンから離れ、スピーカーフォンの音声は避けます。
- 同時発話をしないよう促す。発言の間に少し間を置くだけで、はっきり違いが出ます。
- 開始時に一人ずつ名前を一度言ってもらう。後から名前を付けるときの手がかりになります。
- 発言をある程度の長さにする。1語より1〜2文のほうがグループ化しやすくなります。
- 重要な会議では1分間のテストを行う。会話が複雑になる前にラベルを確認します。
- 後からラベルを修正する。名前変更と統合は、録音し直すより通常は速く済みます。
文字起こし後のラベルの修正
すべての発言を正しく処理できるモデルはないため、実務上の問いは「どれだけ速く修正できるか」です。Scribo では文字起こしを開き、「話者1」「話者2」をその場にいる人の名前に変更し、まとめるべきグループを統合し、誤った話者に付いたセグメントを調整します。音声はリンクされたままなので、疑わしいセグメントを変更する前に聞き直せます。
プライバシーと話者データ
話者ラベルは文字起こしの一部なので、文字起こしとともに端末内に残ります。Scribo のコアの文字起こし経路では、録音、文字起こし、話者情報をサーバーにアップロードしません。話者分離は会議をまたいで人を特定する用途にも使われません。ラベルは1回の録音に属します。
よくある質問
話者ダイアライゼーションとは何ですか?
ダイアライゼーションとは、録音をセグメントに分割し、話者ごとにグループ化する処理です。文字起こし上で誰がいつ話したかを示せるようになります。答えるのは「ここに何人の声があり、それぞれいつ話したか」であり、「この人の名前は何か」ではありません。
Scribo は人を名前で自動的に特定できますか?
いいえ。話者分離は声を「話者1」「話者2」などの匿名のラベルにグループ化します。文字起こしの後にグループの名前変更、調整、統合ができるので、その場にいる人に合わせた文字起こしにできます。
2人が1人の話者にまとめられたのはなぜですか?
声が似ている場合、同時に話している場合、1人の発話がごく短い場合、モデルが同一の声とみなすことがあります。後から話者グループを統合・分割するほうが、録音し直すより通常は速く済みます。
話者分離はオフラインで動作しますか?
Scribo では、1回の会議内の話者分離は端末上で実行されます。音声モデルは初回利用前のダウンロードと検証が必要で、サブスクリプションの確認にはネットワークが必要ですが、コアの文字起こしと話者分離は録音をアップロードしません。
話者のデータはサーバーにアップロードされますか?
話者ラベルは文字起こしとともにアプリのローカルストレージに保存されます。Scribo のコアの文字起こし経路では、録音、文字起こし、話者情報をサーバーにアップロードしません。
はじめる
会議を、読める会話に変えましょう
無料ダウンロードで60分の文字起こしが付属。アカウント登録なしで始められます。