指南
iPhone 說話者分離
說話者分離(又稱 diarization)會依「誰在什麼時候說話」把文字稿分組,讓一大段文字變成可以跟著讀、可以搜尋、可以整理成紀錄的對話。它不是聲紋辨識:應用程式只標出匿名的聲音,由你決定誰是誰。
- 說話者分離標出誰在什麼時候說話,但不知道每個人的名字。
- 清楚的輪流發言、安靜的空間和置中的麥克風,能得到最好的標籤。
- 重疊發言、相似聲音和極短的回應最難處理。
- 語可尋讓你在轉寫後重新命名、調整或合併說話者分組。
說話者分離到底做了什麼
說話者分離分兩個階段進行:
- 切分。把錄音切成一段段被停頓隔開的語音。
- 分組。把聽起來像同一個聲音的段落歸到同一個標籤下,例如說話者 1 或說話者 2。
結果是一份能跟著會議你來我往的文字稿。它不會做的事,是辨識出某個人:不會把聲音對應到帳號、聯絡人或姓名。在語可尋裡,標籤一開始是匿名的,你可以自行重新命名。
為什麼會議和訪談需要它
- 可讀性。沒有說話者區分的文字稿很難快速掃讀,標籤讓結構一目了然。
- 筆記與會議紀錄。可以看出誰提出觀點、誰表示同意、誰負責下一步。
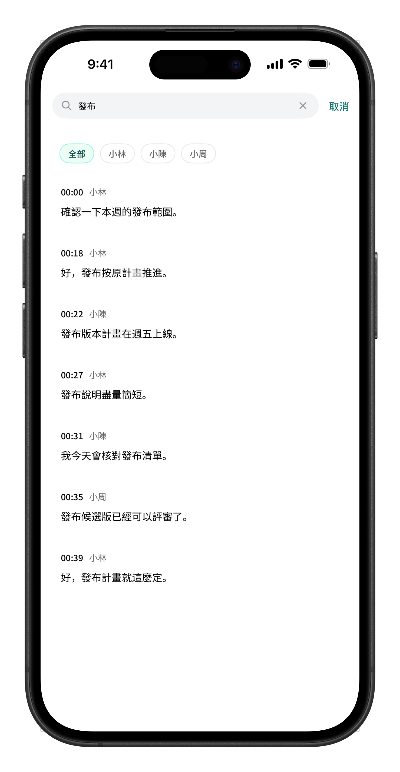
- 搜尋。VIP 使用者可以依關鍵字和說話者搜尋,再跳回對應的音訊。
- 查核。日後決策受到質疑時,說話者標籤加上時間戳記,讓對話更容易核對。
語可尋如何處理說話者分離
- 語音辨識與單場會議的說話者分離都在裝置上執行。
- 文字稿沿時間軸顯示說話者標籤,並附上時間戳記。
- 轉寫後可以重新命名說話者、調整分組,或合併屬於同一個人的分組。
- 點按段落即可回到錄音中的對應位置。
說話者分離難在哪裡
說話者分離是盡力而為的處理,不是保證結果。常見的失敗情境都很實際,並不神祕:
- 重疊發言。兩個人同時說話時,音訊裡是混在一起的兩個聲音。
- 距離與噪音。手機放在長桌另一端、冷氣運轉或咖啡廳背景音,都會讓聲音特徵變得模糊。
- 相似的聲音。音高和節奏相近的人,比較容易混淆。
- 短促的插話。一句快速的「好」或「嗯」,可能沒有足夠的音訊可供穩定分組。
- 快速輪替。在句子中間插話的說話者,會形成一段連續的語音。
- 語言切換。同一場會議混用多種語言,會增加模型必須處理的變化。
如何取得更清楚的說話者標籤
- 把手機放在桌面中央附近。一台裝置置中,通常比放在桌子一端好。
- 降低背景噪音。關窗、遠離冷氣,避免使用擴音通話。
- 請大家不要同時說話。輪流發言之間留一點停頓,差別很明顯。
- 請每個人開場時說一次自己的名字。之後重新命名時就有依據。
- 讓每次發言維持適當長度。一兩句話比單一個詞更容易分組。
- 重要會議先試錄一分鐘。在對話變複雜之前先檢查標籤。
- 事後再修正標籤。重新命名和合併,通常比重新錄音快。
轉寫後修正標籤
沒有模型能把每個輪替都判對,所以實際的問題是:你能多快修正。在語可尋裡,打開文字稿,把說話者 1 和說話者 2 改成會議室裡的人、合併屬於同一人的分組、調整落到錯誤說話者的段落。音訊仍然保持連結,修改前可以先聽一下有疑問的段落。
隱私與說話者資料
說話者標籤屬於文字稿的一部分,因此也跟著文字稿留在裝置上。語可尋的核心轉寫流程不會把錄音、文字稿或說話者資訊上傳到伺服器。說話者分離也不會用來跨會議辨識同一個人;標籤只屬於單次錄音。
常見問題
什麼是說話者分離(diarization)?
說話者分離是把錄音切成段落,再依說話者分組的處理,讓文字稿能顯示誰在什麼時候說話。它回答的是「這裡有幾個聲音、各自在什麼時候說話」,而不是「這個人叫什麼名字」。
語可尋會自動辨識出每個人的名字嗎?
不會。說話者分離會把聲音分成匿名標籤,例如說話者 1 和說話者 2。轉寫後你可以重新命名、調整或合併這些分組,讓文字稿符合會議室裡實際的人。
為什麼兩個人被合併成同一個說話者?
當聲音相似、彼此搶話,或某個人只說了幾個簡短的詞,模型可能把他們視為同一個聲音。事後合併或拆分說話者分組,通常比重新錄音快。
說話者分離可以離線使用嗎?
在語可尋中,單場會議的說話者分離在裝置上執行。語音模型必須在首次使用前下載並校驗,訂閱權益校驗需要網路,但核心轉寫與說話者分離不會上傳錄音。
說話者資料會上傳到伺服器嗎?
說話者標籤會和文字稿一起存在應用程式的本機儲存空間。語可尋的核心轉寫流程不會把錄音、文字稿或說話者資訊上傳到伺服器。
開始使用
把會議變成讀得懂的對話
免費下載,包含 60 分鐘轉寫額度;無需註冊帳號即可開始。