指南
iPhone 说话人分离
说话人分离(speaker separation,也称 diarization)按“谁在什么时候说话”把文字稿分组。它把一整片文字变成可以跟随、搜索并整理成纪要的对话。它不是声纹识别:应用只标注匿名人声,由你来确认他们是谁。
- 说话人分离标注谁在何时发言,但并不知道每个人的姓名。
- 清晰的发言轮次、安静的房间和居中的麦克风能带来最好的标记。
- 抢话、相似嗓音和极短回应是最难处理的情况。
- 语可寻支持在转写后重命名、调整或合并说话人分组。
说话人分离到底做了什么
说话人分离分两个阶段工作:
- 分段。录音被切分为由停顿分隔的短语音片段。
- 分组。听起来像同一个人的片段被归到同一个标记下,例如“说话人 1”或“说话人 2”。
结果是能跟随会议来回对话的文字稿。它做不到的是识别人:不会把声音匹配到账号、联系人或姓名;在语可寻中,标记默认匿名,你可以自行重命名。
它对会议和访谈为什么重要
- 可读性。没有说话人变化的文字稿很难扫读,标记让结构一目了然。
- 记录与纪要。能看出谁提出了观点、谁表示同意、谁负责下一步。
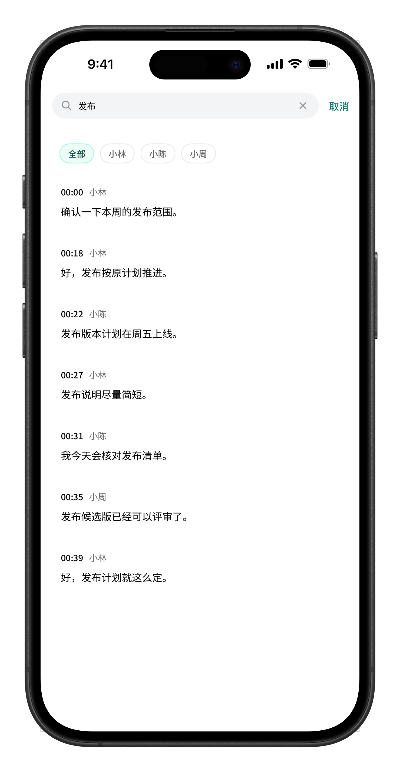
- 搜索。VIP 用户可以按关键词和说话人搜索,再跳回对应的音频位置。
- 复核。日后对某个决定有疑问时,说话人标记加时间戳让对话更容易核实。
语可寻如何处理说话人分离
- 语音识别和单场会议的说话人分离在设备上运行。
- 文字稿按时间轴显示说话人标记和时间戳。
- 转写后可以重命名说话人、调整其分组,或合并属于同一个人的分组。
- 点击某个片段可以回到录音中的对应位置。
说话人分离为什么难
说话人分离是一个尽力而为的过程,而不是有保证的结果。常见的失败情况是物理原因,并不神秘:
- 抢话。两个人同时说话时,音频里是两种声音混在一起。
- 距离与噪声。手机放在大桌子另一端、空调声或咖啡馆背景会模糊声音特征。
- 相似嗓音。音高和节奏相近的人更容易被混淆。
- 简短插话。一句快速的“好”或“可以”可能没有足够的音频来可靠分组。
- 快速轮流发言。在别人句子中间接话的说话人,会形成一整段连续的语音。
- 语言切换。同一场会议中混用多种语言,会增加模型需要处理的差异。
如何获得更清晰的说话人标记
- 把手机放在桌子中央附近。一台设备放中间,通常比放在桌子一端更好。
- 减少背景噪声。关窗、远离空调,避免使用免提外放。
- 请人们不要抢话。轮流发言之间稍作停顿,效果肉眼可见。
- 让每个人在开始时说一次自己的名字。这为之后的改名提供参照。
- 让每次发言保持适当长度。一两句话比单个词更容易正确分组。
- 重要会议先做一分钟测试。在对话变复杂之前检查标记效果。
- 事后修正标记。重命名和合并通常比重新录音更快。
转写后修正说话人标记
没有模型能把每一次发言都分对,所以实际问题是你能多快纠正。在语可寻中,打开文字稿,把“说话人 1”和“说话人 2”改成会议室里的具体的人,合并应属于同一人的分组,调整分错人的片段。音频始终与文字稿关联,修改前可以先听一听有疑问的片段。
隐私与说话人数据
说话人标记是文字稿的一部分,因此和文字稿一起留在设备上。语可寻的核心转写链路不会把录音、文字稿或说话人信息上传到服务器。说话人分离也不会跨会议识别同一个人;标记只属于单次录音。
常见问题
什么是说话人分离(diarization)?
Diarization(说话人分离)是把录音切分成片段并按说话人分组的过程,这样文字稿就能显示谁在什么时候说话。它回答的是“这里有几个声音、每个声音何时出现”,而不是“这个人叫什么名字”。
语可寻能自动识别出人的姓名吗?
不能。说话人分离把声音归入“说话人 1”“说话人 2”这样的匿名标记。你可以在转写后重命名、调整或合并这些分组,让文字稿与会议室里的真实人物对应。
为什么两个人被合并成了同一个说话人?
当嗓音相似、人们互相抢话,或某人只说了几个短词时,模型可能把他们当成同一个声音。事后合并或拆分说话人分组,通常比重新录音更快。
说话人分离可以离线使用吗?
在语可寻中,单场会议的说话人分离在设备上运行。语音模型必须在首次使用前下载并校验,订阅校验也需要网络,但核心转写和说话人分离不会上传录音。
说话人数据会上传到服务器吗?
说话人标记与文字稿一起保存在应用的本地存储中。语可寻的核心转写链路不会把录音、文字稿或说话人信息上传到服务器。
开始使用
把会议变成可以阅读的对话
免费下载,包含 60 分钟转写额度;无需注册账号即可开始。